DesktopPet 是一只常驻在 macOS 桌面上的猫,点一下它就可以打开对话框聊天,在任意 App 里划选一个英文单词可以直接看到释义并记进生词本,听英文课或者讲座的时候它能把声音实时转成字幕,下课后再把整场内容整理成一份中文笔记。项目已经开源在 GitHub,代码主要由 Claude Code 等 AI coding agent 协作完成,我负责的是需求和交互的定义、日常使用中的验收,以及各个环节的模型对比和选择。
为什么要做这个
出国读书以后,课程、讲座和线上会议基本都是英文的,上课的时候经常要同时开好几个工具,听不清的时候要看字幕,遇到生词要去查词典,课后还要回看录播整理笔记。其实飞书妙记之类的产品已经有很成熟的方案,但这些功能分散在不同的窗口里,来回切换很打断注意力,另外我自己也想研究一下本地部署模型的实际效果。
所以我想做的是一个常驻在桌面最上层、随时可以唤起的入口,把学习要用的几个功能集中在一起,形象用的是我以前养的一只银渐层,一个有陪伴感的小猫比一个工具面板更让人愿意一直开着。最开始提给 AI 的需求只有三条:一个置顶的桌面宠物,可以对话;输入或者划选英文单词时给出翻译并记录生词;播放英文视频时流式输出字幕。在动手之前,我先让它调研了有没有已经落地、容易改造的开源项目,再根据调研结果给方案。
先把功能收窄
第一版是在一个开源的数字人项目上改的,这个项目本身带了很多东西,比如角色人设、语音合成、Live2D 模型和好几种窗口模式。我觉得桌宠既然是用来学习的,就不应该有太多和学习无关的表演功能分散注意力,所以把人设和语音合成都删掉了,只保留桌宠形态、对话和查词记词,字幕放到下一步再做。
删人设的时候遇到了一个有意思的问题。原型里有一个照着配置模板写的人设,角色名叫「奶糖」,删掉之后对话里还是会时不时冒出这个名字。排查后发现原因出在我的助理记忆库上,里面其实混着两类内容,一类是带日期的事件记录,记的是当时发生了什么,保留下来没有问题;另一类是描述当前状态的档案,写进去的时候是对的,但之后没有跟着项目更新,里面还写着"当前使用奶糖人设",每次检索的时候就会被重新召回。最后的处理办法是事件记录保留,状态档案更新。这件事让我意识到长期记忆里的"历史"和"现状"需要分开管理,历史记录放着不会出错,但现状如果不及时更新,过一段时间就会变成错误的信息。
细节决定了它能不能一直开着
一个常驻桌面的工具,用起来舒不舒服很大程度上取决于焦点、输入法、气泡位置、屏幕边界和动画节奏这些细节,而不是功能有多少。实际用了一段时间之后,我提的修改基本都集中在这些地方,比如对话气泡要跟着猫移动,并且根据猫在屏幕的哪个角落自动翻转方向,始终留在屏幕里面;点猫打开或收起气泡,点别的地方自动收起;打开气泡时输入框直接获得焦点,去掉发送按钮只用回车发送,也去掉了关闭按钮;中文输入法的候选词不能被气泡挡住;猫可以拖到外接显示器上,但不能被拖到找不回来的位置,启动时默认出现在主屏幕上。
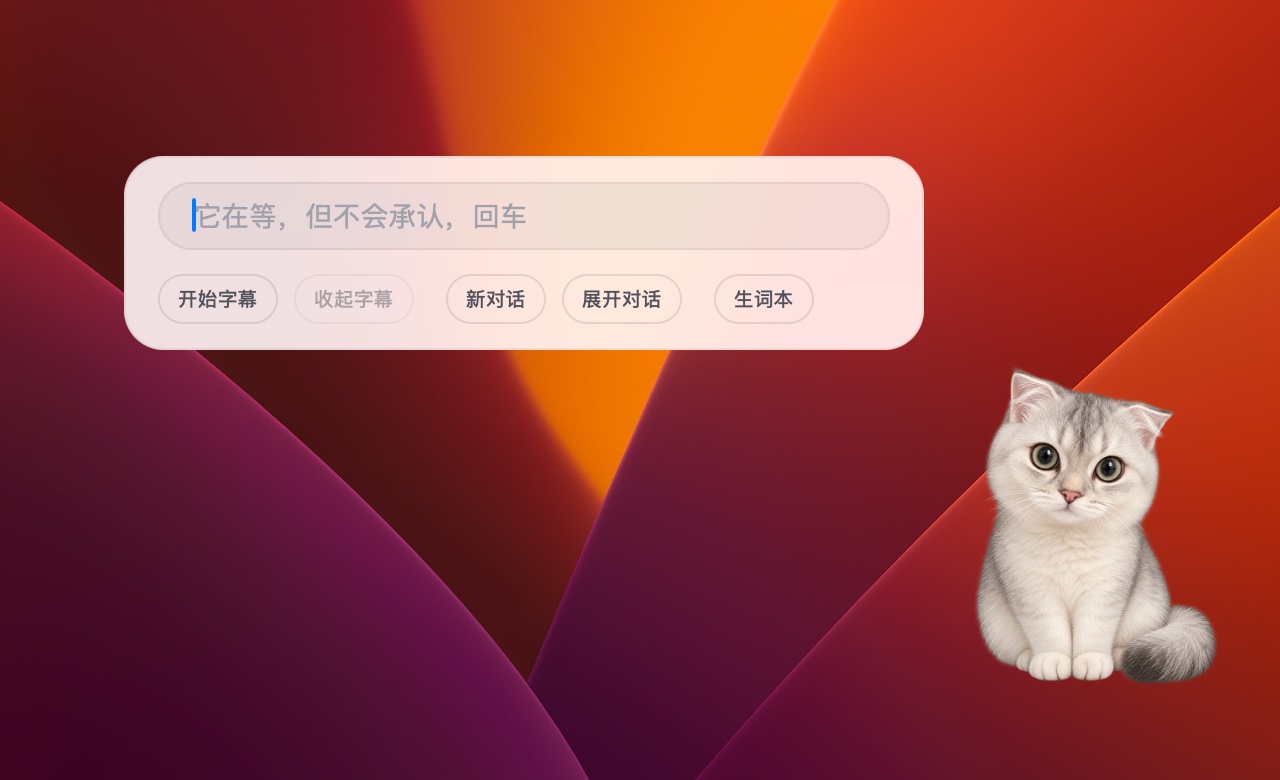
点一下猫打开的对话框,输入框自动获得焦点,回车发送,下面是字幕、对话和生词本的入口
猫的动作节奏我也按照真实的猫来设计:没人理的时候它在睡觉,点一下会爬起来 wink 一下再坐好,气泡收起后大约 5 秒会打个哈欠,再过一会儿就重新趴下睡觉。字幕的验收标准也是从阅读体验出发的,同一段视频里,字幕的停顿不能出现在一句话的中间。
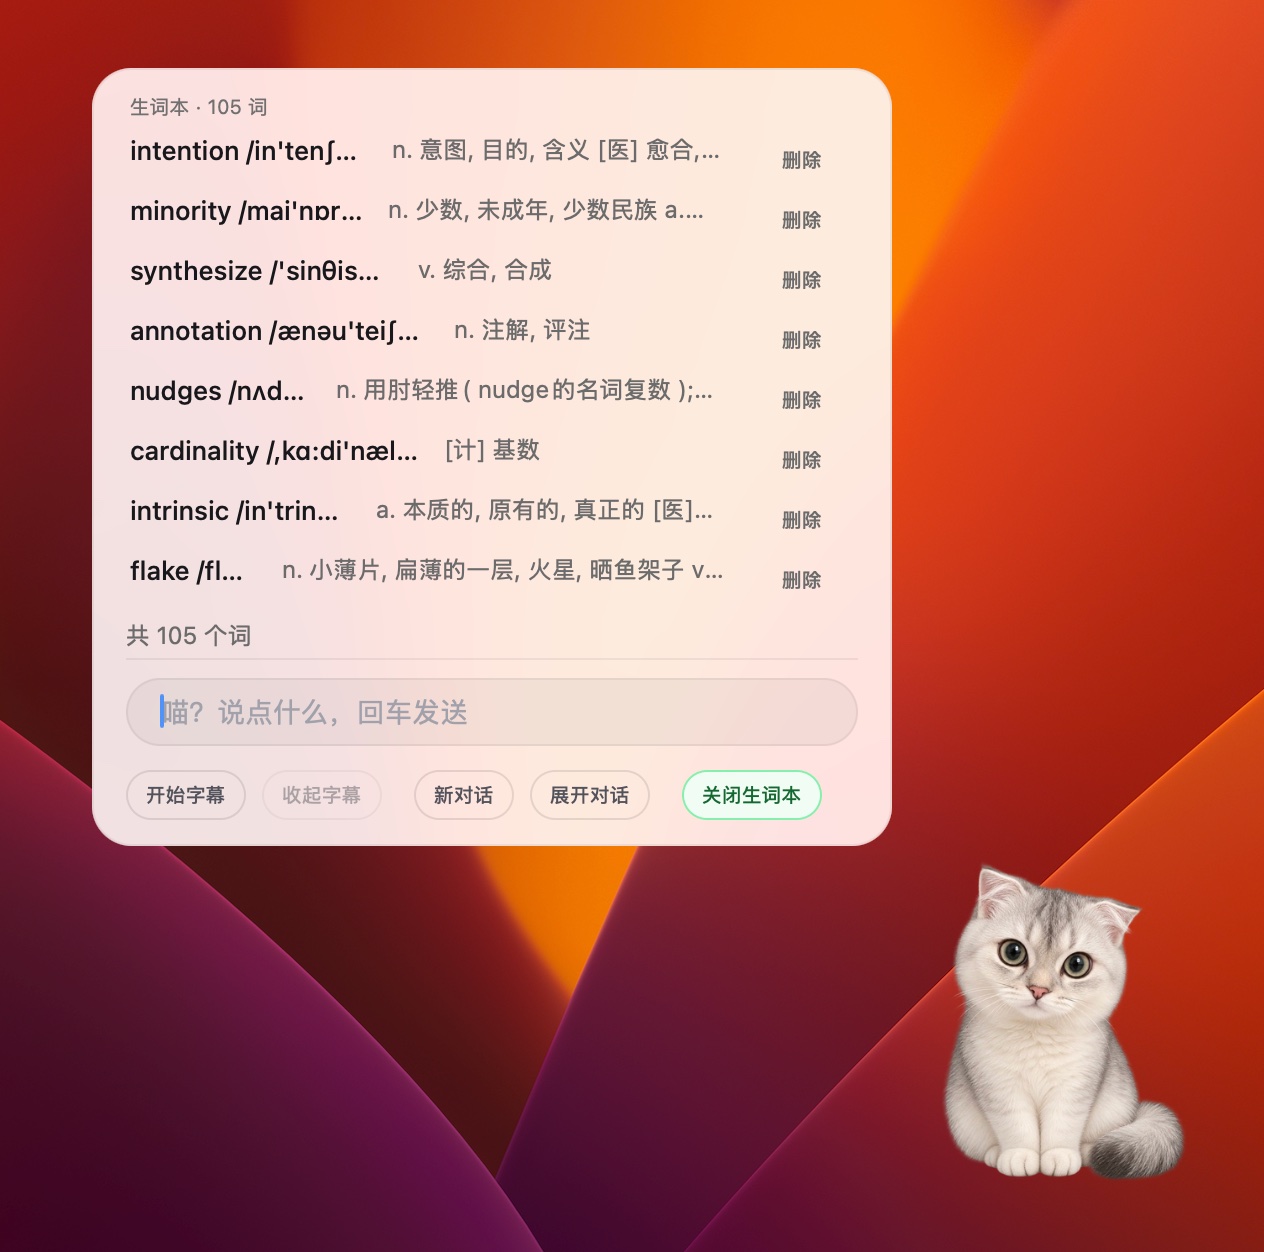
生词本,查过的单词都记在这里,可以随时回看和删除
字幕:两个场景,按环节选模型
字幕是这个项目里花时间最多的部分,也让我对本地模型有了更具体的认识。
做下来我发现这里其实有两个不同的场景。一个是在线会议和讲座的实时字幕,对实时性要求很高,模型必须支持流式输出;另一个是给已有的录音或视频加字幕,对实时性要求低一些,字幕晚一点出来也可以,但需要一次处理完整段内容,准确性更重要。
最早的实现是把音频按固定时长切成小段交给 Whisper 转写,结果字幕大约每 6 秒才整段出来一次,读起来一顿一顿的。后来我用同一段课程录音对比了 macOS 自带的 SpeechAnalyzer 和 Whisper large-v3,SpeechAnalyzer 大约每秒就能刷新一次,速度快了 7 到 11 倍,但它为了速度牺牲了理解能力,缺少上下文语境,最多只能根据当前这句话来推测,专业术语的识别也更差,给它提供术语表实测也没有任何效果。
所以最后我没有只选一个模型,而是按环节分工,下面是我自己日常在用的本地方案:
| 环节 | 方案 | 选择依据 |
|---|---|---|
| 课上实时字幕 | Apple SpeechAnalyzer,麦克风或系统声音二选一,同时保存录音 | 只有它的延迟足够低 |
| 课后重新转写 | 先让 Claude Sonnet 从实时字幕里提取术语表,再用本地的 Qwen3-ASR 带着术语表把录音重新转写一遍 | 在一节 106 分钟的课里,8 个已知容易认错的术语,Qwen3-ASR 认对了 7 个,Apple 只认对 1 个 |
| 课堂笔记 | Sonnet 通读整场字幕写中文笔记,再用代码逐条核对引文和时间戳 | 本地小模型分批总结的效果不够理想 |
分工的考虑主要是节省 token,把重复、机械、量大的工作交给本地模型,把需要通读全文、理解上下文的工作交给云端的大模型。对于模型输出不可靠的地方,我尝试用两类护栏来约束,一类是代码护栏,检查笔记里的每条引文能不能在字幕原文中找到、时间戳是否对得上;另一类是小模型护栏,用小模型做术语校正,对比下来 Qwen 4B 和 9B 的校正结果一致,但 4B 快了大约 3 倍。一场 68 分钟的分享,最后生成的笔记里 41 条引文和 209 个时间戳全部通过了校验。
这些模型都是在同一份素材上直接对比输出结果选出来的,比较的时候我主要考虑三个方面:一是模型大小和性能,电脑能不能撑得住、速度够不够快;二是结构化输出和指令遵循能力,能不能按要求输出规范的字幕,会不会把提示词当成字幕内容输出;三是识别质量,包括对杂音和环境音的幻觉情况,以及专业术语、数字和公式的识别。
还没有做好的地方:动画
我希望桌宠足够精美逼真,动作足够丝滑,但目前还没有实现比较好的效果,几种方案都试过,各有各的问题。Codex 和 Hermes 自带的宠物素材像素都比较低,猫的毛发质感出不来;用 GIF 的话颜色数量有限,同样影响毛发的质感;先生成视频再抽帧,处理起来很麻烦,而且很难精确控制宠物的动作,比如猫跑到一半被点了一下、回头看你,这种交互可能就实现不好。
现在采用的是用 GPT 逐帧生图、再用代码拼接成动画的方式,单帧画面的精度有保障,但 GPT 做不到多帧之间的对齐,生成的几张图边缘位置会有细微差异,连起来播放的时候动作就会有卡顿、不连贯的感觉。
和 AI 协作开发
这个项目的代码几乎都是 AI coding agent 写的,我的工作主要是定义需求和验收标准、在日常使用中发现问题、决定功能上的取舍、判断模型对比的结果,并对最后的效果负责。开发过程中项目整体重写过一次,改成了原生的 macOS 应用,重写之前先把关键功能的行为录成了 20 个回归用例,新版本逐条对照验证,避免只凭感觉判断"看起来差不多"。
目前的开源版本需要 macOS 26 以上和 Apple Silicon 芯片,默认接入任意 OpenAI 兼容的接口,也可以接本机的 Ollama 或 LM Studio;上面提到的"Qwen3-ASR 重新转写 + Sonnet 笔记"是我本机的配置,没有放进开源版本的默认功能里。
文章开头的视频也是用代码做的,画面是用 HTML 写的 2D 动画,逐帧截图后合成,背景音乐也是用程序合成的。